Le blind index expliqué simplement : chercher dans des données chiffrées
Chiffrer une donnée sensible dans une base de données, c’est relativement simple. Le vrai problème arrive souvent plus tard, le jour où il faut… la retrouver.
C’est exactement la situation que nous avons rencontrée sur un projet. Un client nous demandait de protéger plusieurs informations sensibles, dont des numéros de sécurité sociale. La base contenait déjà plusieurs milliers de lignes, et l’application devait continuer à fonctionner comme avant : liste paginée, consultation des fiches et, surtout, recherche.
Le chiffrement en lui-même n’était pas le sujet le plus compliqué. Le vrai problème, c’était de continuer à chercher efficacement dans ces données une fois chiffrées.
C’est ce qui nous a amenés à CipherSweet et aux blind indexes. Voici le chemin que nous avons suivi, les impasses comprises.
Qu’est-ce qu’un blind index et pourquoi en avez-vous besoin ?
Le problème des données chiffrées non interrogeables
Pour comprendre le problème, il faut d’abord rappeler à quoi sert un index classique.
Un index de base de données fonctionne comme un annuaire téléphonique trié : au lieu de lire toutes les pages pour trouver « Martin », on va directement à la lettre M. Techniquement, la plupart des bases (PostgreSQL, MySQL, MongoDB) utilisent une structure en arbre de type B-tree : la colonne indexée est triée, et chaque entrée contient des pointeurs vers les lignes correspondantes. Sans index, la base doit parcourir toutes les lignes une à une. Avec un index, le nombre de lignes parcourues passe de plusieurs milliers à quelques-unes.
Le chiffrement casse ce mécanisme.
Pour afficher une liste paginée, rien de compliqué : si l’écran montre dix personnes, l’application récupère dix lignes, déchiffre les valeurs utiles et les affiche à l’utilisateur autorisé. Le coût reste raisonnable.
Le problème apparaît avec la recherche. Sur notre projet, l’utilisateur devait pouvoir taper une partie du numéro pour retrouver une personne. Avec des données en clair, la requête ressemblerait à ceci :
Nous avons donc cherché une solution. Les deux premières pistes ne tenaient pas.
Première idée : tout déchiffrer côté application. Techniquement, ça marche. Mais à chaque recherche, il faut récupérer potentiellement des milliers de lignes, les transférer vers l’application, déchiffrer chaque valeur, comparer, puis ne garder que deux ou trois résultats. Avec quelques centaines de lignes, ça passe inaperçu. Avec plusieurs milliers ou millions, et une requête exécutée des dizaines de fois par les utilisateurs chaque jour, les performances des requêtes s’effondrent. Et surtout, on déchiffre énormément de données sensibles pour en retrouver quelques-unes.
Deuxième idée : chiffrer le texte recherché et comparer. Impossible pour une recherche partielle. Un bon algorithme de chiffrement ne garde aucune structure : les caractères du ciphertext ne correspondent à aucune partie du texte d’origine. Chiffrer 67890 ne permet pas de retrouver cette séquence dans le ciphertext de 1234567890123.
Troisième idée, que nous avons sérieusement étudiée : un cache Redis.
Comment le blind index résout cette équation ?
Nous voulions plutôt laisser la base faire ce qu’elle sait faire de mieux : retrouver des lignes grâce à un index.
C’est exactement ce que permet le blind index. On ne cherche plus dans la donnée chiffrée : on cherche dans une colonne d’empreintes, qui, elle, peut être indexée normalement. La donnée reste chiffrée, l’index reste un index, et chacun garde son rôle.
Pour le mettre en place, nous avons utilisé CipherSweet, une bibliothèque open source de Paragon Initiative Enterprises, disponible notamment en PHP et en Node.js. Elle fait du field level encryption (chiffrement champ par champ, et non de toute la base) et, surtout, elle ne s’arrête pas au chiffrement : elle fournit aussi un mécanisme de blind indexes intégré.
CipherSweet ne rend pas le contenu chiffré « recherchable » par magie. Elle fournit les outils pour créer, à côté du chiffrement, des index dédiés aux recherches que l’application veut autoriser. C’est cette séparation entre stockage sécurisé de la donnée et mécanisme de recherche qui a répondu à notre besoin.
Définition du blind index en quelques mots
Un blind index (« index aveugle ») est une valeur calculée à partir d’une donnée en clair, avec une fonction de hachage et une clé secrète, et stockée à côté de la version chiffrée de cette donnée. Il répond à une seule question : « dans quelle ligne se trouve la valeur que je cherche ? », sans jamais révéler cette valeur.
| Ciphertext | Blind index | |
|---|---|---|
| Rôle | Protéger la donnée | Retrouver la ligne |
| Réversible ? | Oui, avec la clé de chiffrement | Non, jamais |
| Utilisé pour | Afficher la valeur à un utilisateur autorisé | Faire une requête WHERE blind_index = ? |
On ne déchiffre jamais un blind index. Ce n’est pas une deuxième version chiffrée de la donnée, c’est une étiquette de recherche.
Comment fonctionne un blind index : le mécanisme technique décrypté
La création de l’index à partir des données chiffrées
Dans notre architecture, nous avons stocké les blind indexes dans une table séparée :
Chaque ligne dit à quelle ligne de users appartient l’index (user_id, qui pointe vers la clé primaire), à quel champ il correspond (field_name) et quelle valeur sert à chercher (blind_index).
Cette table séparée est un choix d’architecture de notre application, pas une obligation de CipherSweet. Elle évite d’ajouter des dizaines de colonnes techniques dans users et permet de stocker plusieurs index pour une même donnée, ce qui deviendra indispensable pour la recherche partielle. Un index B-tree classique sur (field_name, blind_index) suffit ensuite à rendre la recherche rapide.
Le processus de recherche sans déchiffrement
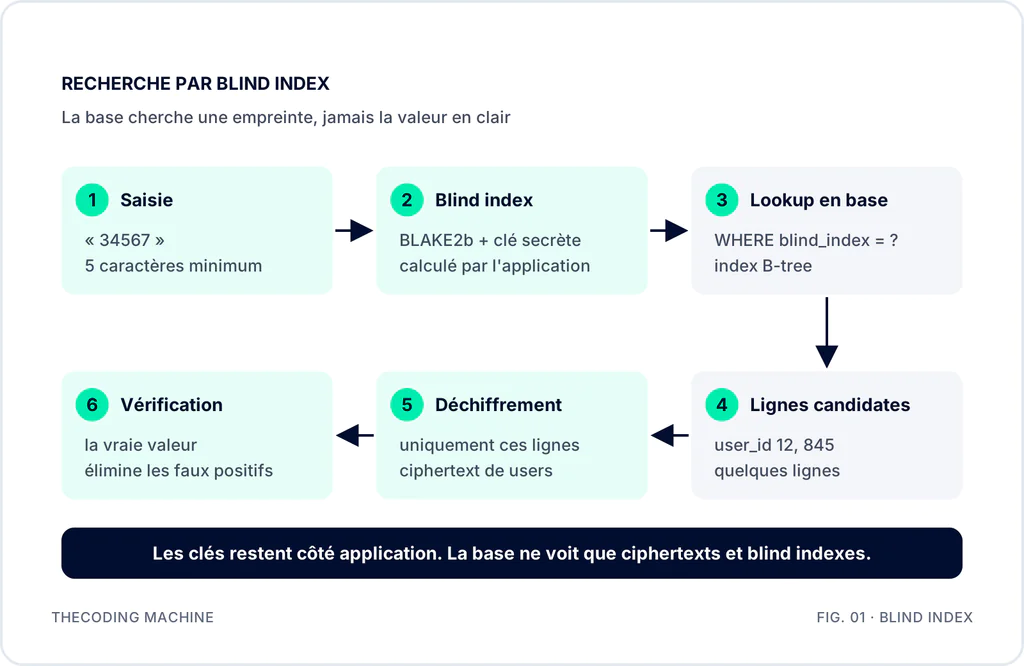
Quand l’utilisateur lance une recherche, l’application calcule le blind index de la valeur saisie, avec la même clé, puis interroge la table :
La base renvoie les identifiants des lignes candidates. L’application récupère leurs ciphertexts dans users, déchiffre uniquement ces lignes et vérifie la vraie valeur.
Le rôle de la fonction de hachage dans le blind indexing
À ce stade, une question revient toujours : pourquoi ne pas simplement stocker un SHA-256 de la valeur ?
Un blind index utilise une fonction de hachage avec clé secrète. Sans la clé, impossible de recalculer les index, donc impossible de les comparer. Dans CipherSweet, l’algorithme dépend du backend choisi :
| Backend CipherSweet | Index « rapide » | Index « lent » |
|---|---|---|
| ModernCrypto | BLAKE2b avec clé | Argon2id (32 Mo de mémoire par défaut) |
| FIPSCrypto | PBKDF2-SHA384, 1 itération | PBKDF2-SHA384, 50 000 itérations par défaut |
L’index lent coûte plus cher à calculer, ce qui ralentit aussi un attaquant qui aurait volé la clé.
L’index rapide suffit quand la clé est bien protégée et que la recherche doit être instantanée.
Cas d’usage concrets du blind index dans les bases de données
Indexation sécurisée pour les systèmes de santé et finance
La santé et la finance sont les secteurs où le blind index a le plus de sens : on y cumule des données très sensibles et un besoin de recherche quotidien.
C’est exactement notre projet. Une recherche exacte sur le numéro complet aurait été simple : un seul blind index par numéro. Mais les utilisateurs devaient pouvoir retrouver une personne en tapant seulement une partie de son numéro de sécurité sociale.
CipherSweet ne permet pas d’exécuter un LIKE ou une expression régulière sur une donnée chiffrée. En revanche, un blind index peut être calculé sur une transformation de la valeur d’origine, et notamment sur un morceau de cette valeur. C’est ce principe que nous avons utilisé :
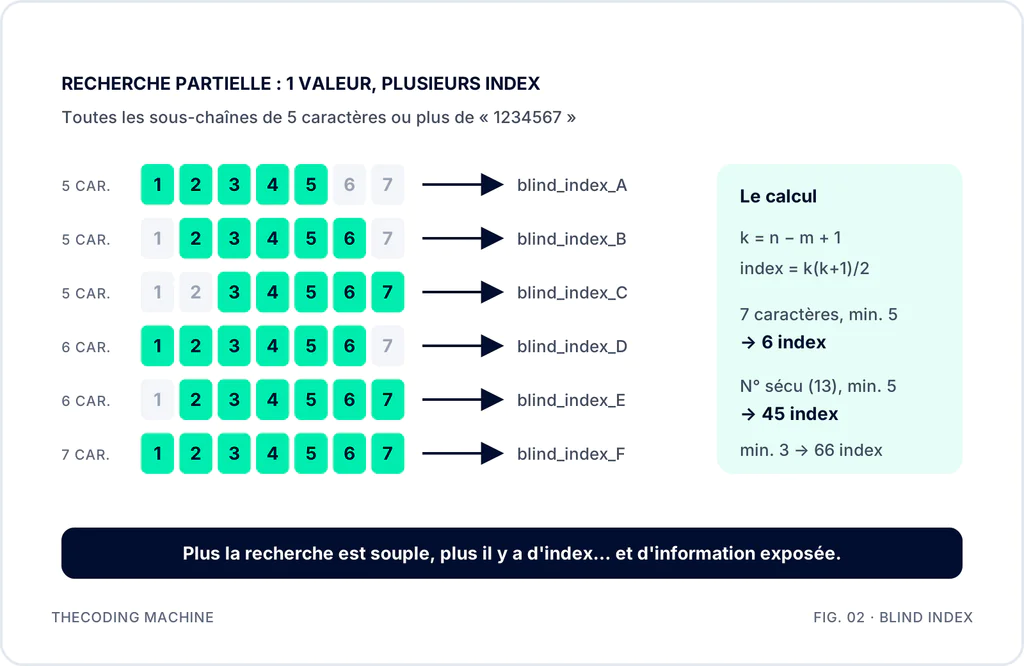
Cette approche fonctionne, mais elle a un prix.
C’est pour ça que nous avons fixé le seuil à 5. Ce n’est pas une contrainte de CipherSweet, c’est un choix d’architecture pour trouver l’équilibre entre l’expérience utilisateur, la précision de la recherche, le stockage, les performances et la quantité d’information que ces index peuvent révéler. Nous y revenons dans les limites, plus bas.
Protection des données sensibles dans les applications web
Hors santé et finance, c’est le cas d’usage que nous rencontrons le plus souvent : une application métier sur mesure qui manipule des données personnelles, et dans laquelle les équipes doivent pouvoir chercher.
Exemples typiques :
- retrouver un client par son email ou son numéro de téléphone sans les stocker en clair ;
- vérifier qu’un IBAN n’est pas déjà enregistré avant d’en ajouter un nouveau ;
- rechercher un dossier à partir d’un numéro de contrat.
Dans la plupart de ces cas, une recherche exacte suffit. C’est la configuration la plus simple et la plus sûre : un seul blind index par champ.
Field level encryption avec MongoDB
Le blind index n’est pas réservé aux bases relationnelles comme PostgreSQL. Avec MongoDB, deux options existent :
- les fonctions natives de MongoDB : le Client-Side Field Level Encryption (CSFLE) avec chiffrement déterministe pour les recherches par égalité, et Queryable Encryption, qui gère l’égalité, les plages et, dans les versions récentes, les recherches par préfixe, suffixe et sous-chaîne sur des encrypted fields ;
- un blind index applicatif, calculé par votre code et stocké dans un champ indexé du document, comme nous l’avons fait avec PostgreSQL.
Le choix dépend surtout de votre stack. Les fonctions natives sont confortables si vous êtes déjà sur une version et une offre MongoDB qui les proposent. Le blind index applicatif reste portable : la même logique fonctionne si vous changez de base demain.
Les avantages et limites du blind index en 2026
Impact sur les performances des requêtes
Côté lecture, le gain est spectaculaire sur notre projet.
La recherche redevient une requête indexée classique, avec des performances de base de données comparables à une recherche en clair. C’est précisément ce que nous cherchions.
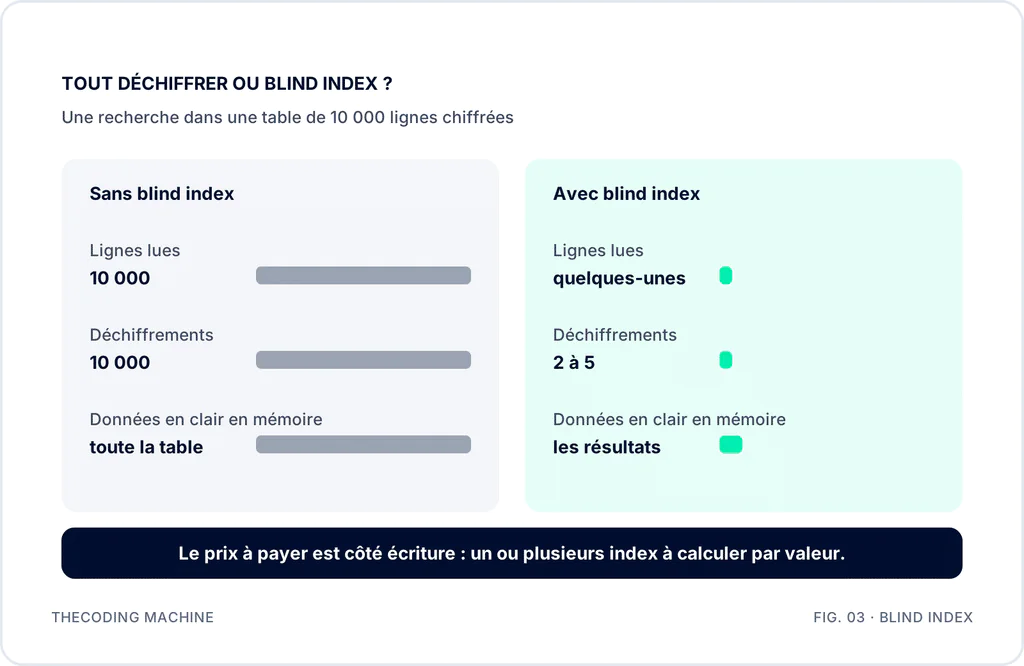
Côté écriture, en revanche, il y a un coût. Chaque insertion ou modification calcule et stocke un ou plusieurs index en plus du chiffrement. C’est négligeable avec un seul index par champ. Avec nos 45 index par numéro, chaque modification impose de supprimer et recalculer tous les index de la valeur.
Les contraintes techniques à anticiper
Le blind index n’est pas magique. Voici ce qu’il ne fait pas :
- Pas de tri. Les empreintes n’ont aucun ordre lié à la valeur d’origine.
ORDER BYsur un champ chiffré reste impossible. - Pas de recherche par plage. « Toutes les dates de naissance entre 1980 et 1990 » ne fonctionne pas avec un blind index d’égalité.
- Pas de
LIKEnatif. La recherche partielle est possible, mais seulement en préparant à l’avance les morceaux de texte recherchables, comme nous l’avons fait.
Et surtout, la limite la plus importante à comprendre : plus d’index signifie aussi plus d’informations exposées.
Le chiffrement et le blind index n’ont pas le même objectif. Un ciphertext est conçu pour révéler le moins possible sur la donnée d’origine. Un blind index, au contraire, doit garder assez de propriétés pour permettre une recherche : deux lignes qui ont le même blind index ont (probablement) la même valeur. Créer beaucoup d’index sur une même donnée multiplie donc les possibilités de recoupement.
La documentation de CipherSweet recommande explicitement d’utiliser les blind indexes avec parcimonie. Multiplier les transformations d’une même valeur permet à un attaquant qui connaît certaines valeurs d’en déduire progressivement d’autres, comme on remplit une grille de mots croisés. La documentation appelle ce phénomène la « crossword puzzle attack ».
Sécurité renforcée et conformité RGPD
Ces limites ne doivent pas faire oublier l’essentiel : sans blind index, beaucoup d’équipes renoncent à chiffrer un champ « parce qu’il faut pouvoir chercher dessus ». Et c’est souvent précisément le champ le plus sensible : numéro de sécurité sociale, IBAN, email, numéro de téléphone.
Le blind index n’est pas une exigence du RGPD en soi. Mais il rend possible ce que le RGPD encourage : chiffrer les données personnelles sensibles sans rendre l’application inutilisable.
- L’article 32 du RGPD cite explicitement le chiffrement parmi les mesures de sécurité appropriées.
- L’article 34 prévoit qu’en cas de fuite, il n’est pas obligatoire de prévenir chaque personne concernée si les données étaient rendues incompréhensibles, par exemple grâce au chiffrement.
Bonnes pratiques pour implémenter un blind index
Si nous devions résumer ce que ce projet nous a appris, ce serait ces trois séries de règles.
Choisir le bon algorithme de hachage
- Jamais de hash sans clé (MD5, SHA-1, SHA-256 seuls). Utilisez une fonction avec clé secrète : HMAC, BLAKE2b avec clé, ou une fonction lente comme Argon2id pour les données au format très prévisible.
- Une clé par index. CipherSweet dérive automatiquement une clé distincte pour chaque champ et chaque index à partir d’une clé maître. Si vous codez votre propre solution, faites de même : deux champs ne doivent jamais partager la même clé de blind index.
- Tronquez l’empreinte. Un blind index n’a pas besoin de 256 bits. Une sortie plus courte crée des faux positifs, que l’application élimine au déchiffrement, et réduit ce qu’un attaquant peut apprendre.
- Ne réinventez pas la cryptographie. Une bibliothèque reconnue comme CipherSweet évite la plupart des erreurs classiques. C’est le choix que nous avons fait.
Optimiser la structure de l’index pour vos requêtes
- Partez des recherches réelles. Listez les recherches dont les utilisateurs ont vraiment besoin. Un blind index se conçoit à partir des requêtes, pas à partir des colonnes.
- Préférez la recherche exacte. Elle demande un seul index par champ. Réservez la recherche partielle aux champs où elle est indispensable, avec une longueur minimale.
- Indexez la colonne des blind indexes (B-tree sur
field_name, blind_index), sinon on retombe dans un parcours complet de la table. - Prévoyez la migration des données existantes. Sur une base déjà en production, comme la nôtre, il faut chiffrer et calculer les index de toutes les lignes en tâche de fond, sans bloquer l’application.
Gérer les clés de chiffrement en toute sécurité
- Séparez les clés de la base. Variables d’environnement au minimum, idéalement un gestionnaire de secrets ou un KMS (AWS KMS, Google Cloud KMS, HashiCorp Vault…).
- Limitez qui y a accès. Un développeur n’a pas besoin des clés de production pour travailler.
- Anticipez la rotation. Changer la clé d’un blind index impose de recalculer tous les index existants. CipherSweet fournit des outils de rotation, mais l’opération doit être planifiée.
- Sauvegardez les clés. Une clé perdue, c’est une donnée perdue, définitivement.
Questions fréquentes sur le blind index
Un blind index peut-il remplacer totalement un index classique ?
Non. Un blind index ne permet que des recherches par égalité (ou partielles si on a préparé les sous-chaînes). Il ne permet ni tri, ni recherche par plage, ni recherche floue. Il ne remplace un index classique que pour les champs chiffrés, et seulement pour les recherches prévues à l’avance.
Quelle différence entre blind index et encryption at rest ?
L’encryption at rest chiffre le disque ou les fichiers de la base. Le blind index accompagne un chiffrement champ par champ, fait par l’application. Avec l’encryption at rest, la base voit les données en clair : quiconque accède à la base (requête SQL, sauvegarde mal protégée, compte compromis) les lit. Avec le field level encryption et le blind index, la base ne voit jamais la valeur en clair. Les deux sont complémentaires.
Le blind indexing ralentit-il les opérations d’écriture ?
Oui, un peu, et beaucoup plus avec la recherche partielle. Un index simple ajoute un calcul de hachage par champ, négligeable. Une recherche partielle peut ajouter des dizaines d’index par valeur (45 pour un numéro de sécurité sociale avec un minimum de 5 caractères), et chaque modification impose de les supprimer et de les recalculer. Sur des volumes d’écriture importants, c’est un point à mesurer avant de choisir.
Vous devez protéger des données sensibles sans perdre la recherche ?
Le blind index est un excellent outil, à condition de bien choisir ce que l’on rend recherchable. Avant d’écrire une ligne de code, nous définissons avec vous les recherches réellement utiles, le niveau de sensibilité des données et le compromis acceptable.
Pour une application existante, un audit technique permet de repérer les données sensibles stockées en clair et de chiffrer celles qui doivent l’être.
Publié le 22 octobre 2026
Ayman Benmada
 Voir le profil